Introduction to DBSCAN
Let's briefly explore visually the differences between DBSCAN and other clustering techniques, such as K-Means Clustering.
DBSCAN and Clustering Examples
blobs = pd.read_csv('../DATA/cluster_blobs.csv')blobs.head()X1
X2
0
4.645333
6.82229412 more lines
1
4.784032
6.422883
2
-5.851786
5.774331
3
-7.459592
6.456415
4
4.918911
6.961479sns.scatterplot(data=blobs,x='X1',y='X2')<AxesSubplot:xlabel='X1', ylabel='X2'>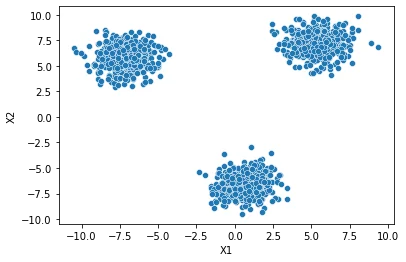
moons = pd.read_csv('../DATA/cluster_moons.csv')moons.head()X1
X2
0
0.674362
-0.44462512 more lines
1
1.547129
-0.239796
2
1.601930
-0.230792
3
0.014563
0.449752
4
1.503476
-0.389164sns.scatterplot(data=moons,x='X1',y='X2')<AxesSubplot:xlabel='X1', ylabel='X2'>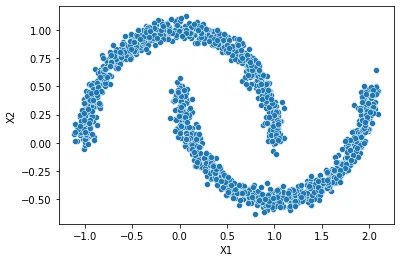
circles = pd.read_csv('../DATA/cluster_circles.csv')circles.head()X1
X2
0
-0.348677
0.01015712 more lines
1
-0.176587
-0.954283
2
0.301703
-0.113045
3
-0.782889
-0.719468
4
-0.733280
-0.757354sns.scatterplot(data=circles,x='X1',y='X2')<AxesSubplot:xlabel='X1', ylabel='X2'>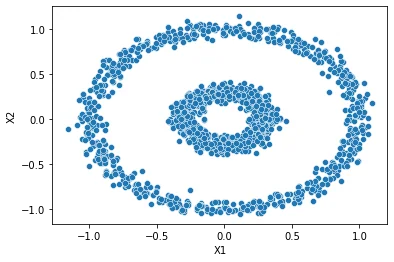
Label Discovery
def display_categories(model,data):
    labels = model.fit_predict(data)
    sns.scatterplot(data=data,x='X1',y='X2',hue=labels,palette='Set1')
Kmeans Results
from sklearn.cluster import KMeans
model = KMeans(n_clusters = 2)display_categories(model,moons)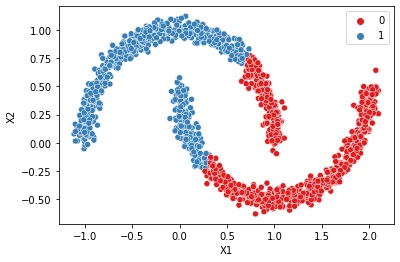
model = KMeans(n_clusters = 3)
display_categories(model,blobs)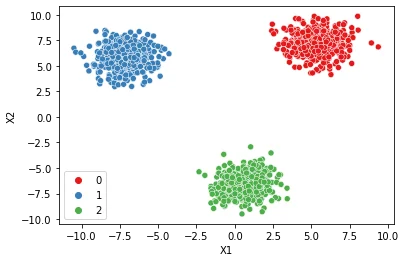
model = KMeans(n_clusters = 2)
display_categories(model,circles)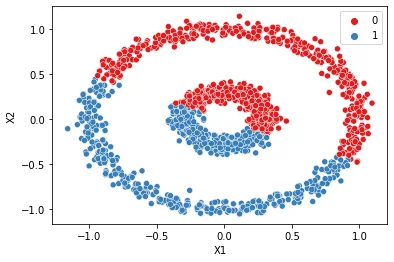
DBSCAN Results
from sklearn.cluster import DBSCANmodel = DBSCAN(eps=0.6)display_categories(model,blobs)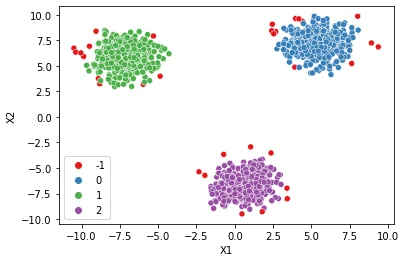
model = DBSCAN(eps=0.15)
plt.figure(figsize=(10,6),dpi=150)
display_categories(model,moons)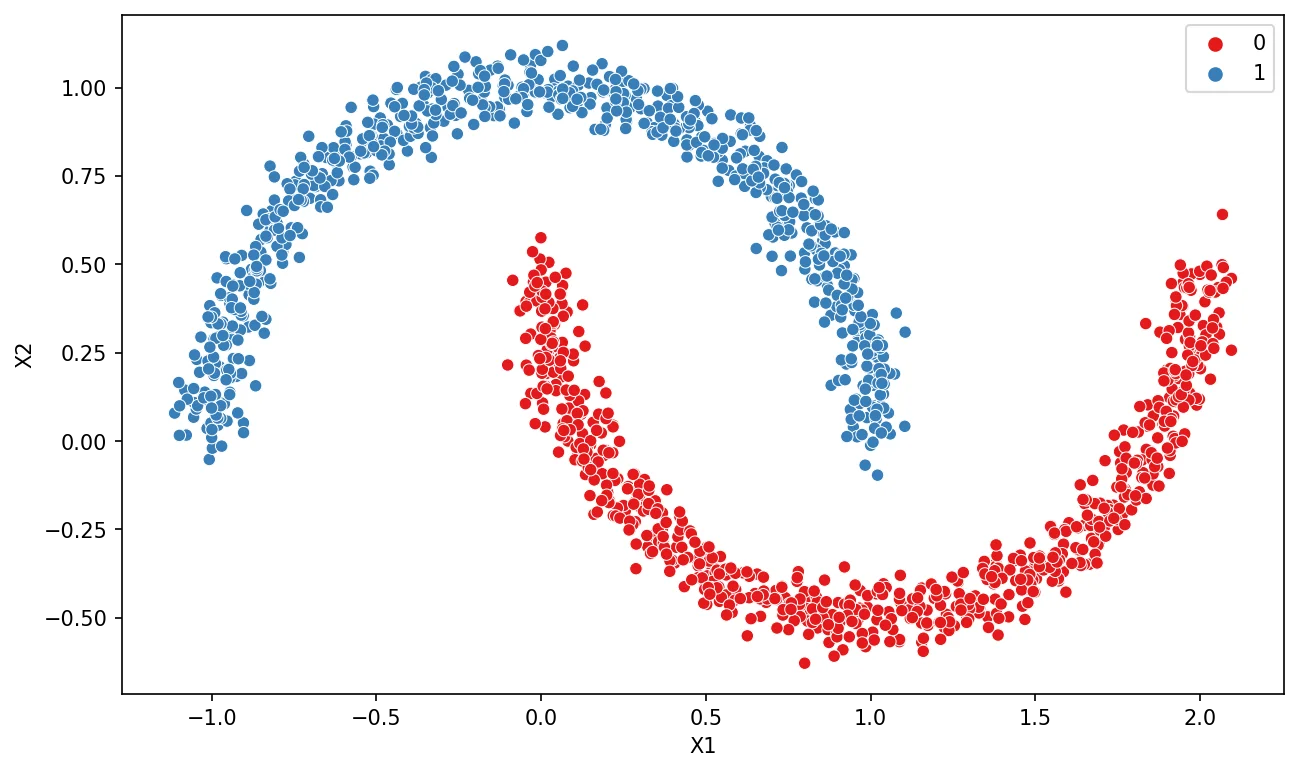
display_categories(model,circles)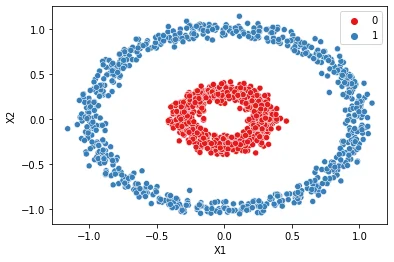
Let's further explore DBSCAN Hyperparameters!